Догоняют ли открытые модели?
- title
- Догоняют ли открытые модели?
- type
- summary
- summary
- SemiAnalysis заново прогнали бенчмарки разных эпох для открытых и закрытых LLM: время отставания сокращается почти вдвое в каждую эпоху, с 19.7 до 4.8 месяца
- tags
- ai, open-weights, benchmarks, llm, china
- sources
- are-open-models-catching-up
- created
- 2026-09-14
- updated
- 2026-09-14
- lang
- ru
- translation_of
- are-open-models-catching-up
- source_updated
- 2026-09-14
- translated
- 2026-09-14
- translator
- lllm/antigravity/gemini-3.7-flash-medium
SemiAnalysis (Evan Cloutier, Max Kan, Jordan Nanos и Dylan Patel) опубликовали этот материал 21 августа 2026 года после двухмесячной череды релизов, среди которых были GLM-5.3 и kimi-k3. Их исходный тезис: это первые открытые модели, способные выполнять оплачиваемую работу, то есть задачи по написанию кода и агентские сценарии, обеспечивающие Anthropic свыше $65 млрд ARR. DeepSeek R1 гремел в заголовках в январе 2025 года, но, по их оценке, никто не использовал его для чего-то экономически значимого. Доказательством сдвига служит объём токенов: один только Fireworks отдаёт более 40 трлн токенов в день - вдвое больше объёма OpenAI API на конец марта.
Вопрос, на который они пытаются ответить, волнует инвесторов передовых лабораторий: если открытые модели держатся достаточно близко к закрытому frontier'у за малую долю цены, слой моделей коммодитизируется, а вместе с ним исчезает и маржа лабораторий. SemiAnalysis продаёт финансовую модель Anthropic и OpenAI и ссылается на неё трижды за статью, так что у них есть прямой интерес в том, как именно решится этот вопрос.
Свой набор бенчмарков для каждой эпохи
Методология опирается на тезис о бенчмарках: каждый из них привязан к периоду, для которого создавался. Бенчмарк проектируют так, чтобы разделять модели своего времени; лаборатории штурмуют его, пока он не насытится, после чего фокус внимания смещается на следующий. Единый фиксированный набор тестов для моделей 2023 и 2026 годов либо упёрся бы в нижний порог на одном конце, либо насытился на другом. Поэтому авторы разделили историю LLM на три эпохи (раннее масштабирование, reasoning, агентская), выбрали по четыре бенчмарка на эпоху и оценивали модели конкретной эпохи только по её собственным тестам.
| Эпоха | Годы | Бенчмарки |
|---|---|---|
| Раннее масштабирование | 2022 - 2024 | GSM8K, HumanEval, MMLU-Pro, TriviaQA |
| Reasoning | 2024 - 2025 | GPQA-Diamond, AIME 2026, SimpleQA Verified, Humanity's Last Exam |
| Агентская | 2025 - наши дни | Terminal-Bench 2.1, BrowseComp-Plus, τ³-Banking, DeepSWE |
Внутри каждой эпохи лучший результат по каждому бенчмарку принимается за 100, а остальные показатели масштабируются относительно него; итоговый композитный балл модели - это невзвешенное среднее четырёх нормализованных оценок. Большую часть прогонов SemiAnalysis выполнили на стеке оценки Prime Intellect (тестовый harness в Prime-RL); Florian Brand из Prime Intellect помогал отбирать бенчмарки и проверять результаты. Остальные данные взяты у Artificial Analysis и из лидерборда DeepSWE от Datacurve. Открытые модели разворачивали так, как это делалось бы на момент их релиза: с тогдашней версией vLLM, тем же железом и теми же настройками сэмплинга, а закрытые модели запускали через зафиксированные версии API. По словам авторов, выбор бенчмарков определялся отчасти вкусом, отчасти популярностью: у Humanity's Last Exam есть известные проблемы, но в свою эпоху ему не нашлось замены, а DeepSWE заменяет столь же проблемный SWE-bench Pro.
Три эпохи
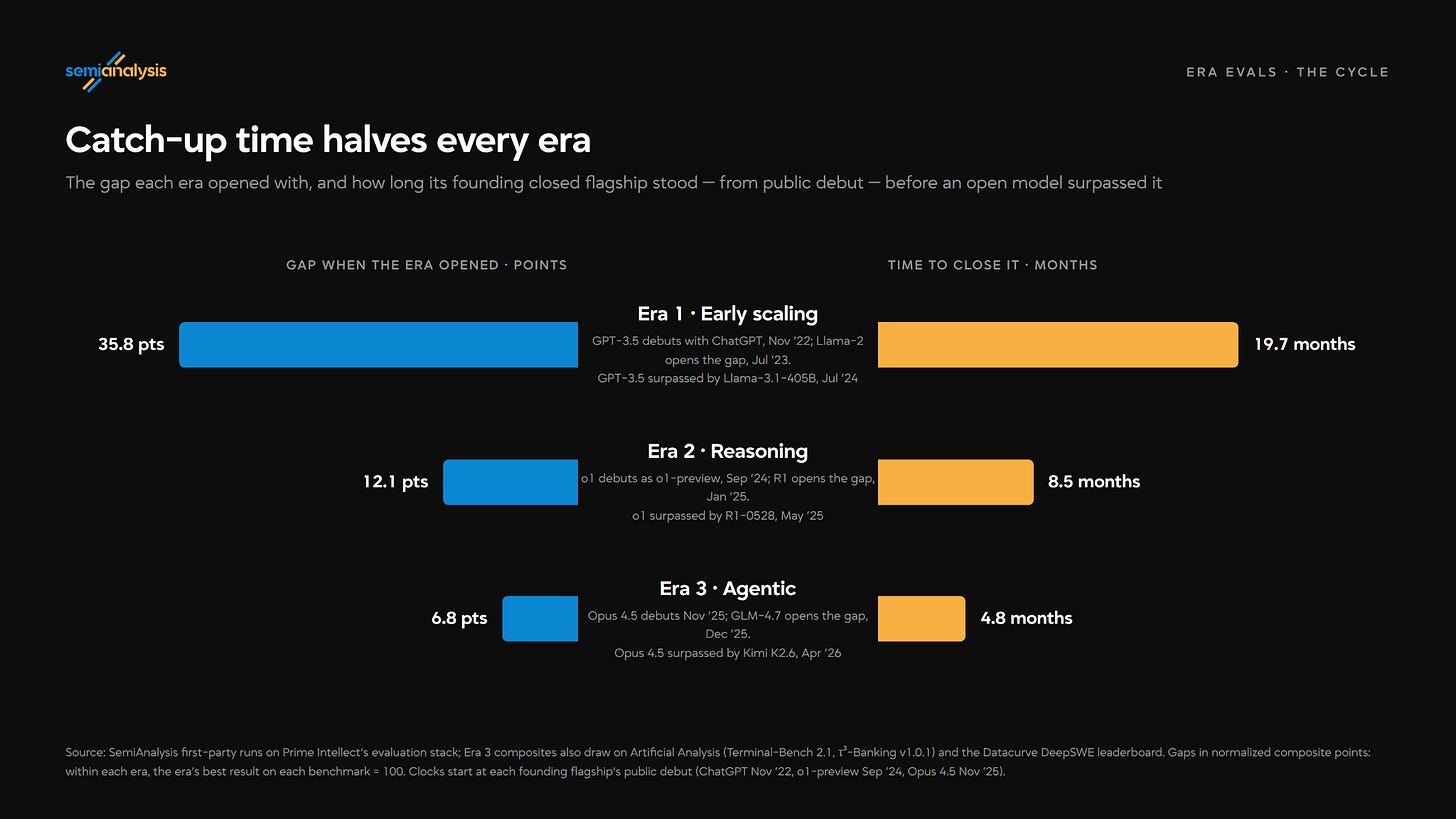
В первую эпоху разрыв был огромным. Llama-2-70B, первая открытая модель, приблизившаяся к frontier'у, набрала 39.9 против 75.7 у GPT-3.5 Turbo - отставание в 35.8 балла. Mixtral-8x7B в декабре 2023 года подобрался ближе к GPT-4, но GPT-4 Turbo и GPT-4o удержали лидерство. Llama-3.1-405B в июле 2024 года наконец обошла GPT-3.5 Turbo с композитным баллом 86, а DeepSeek V3 в декабре 2024 года сравнялся с GPT-4o (94.1 против 95.5), при этом Qwen2.5-72B подошёл вплотную, имея вшестеро меньше параметров, чем 405B. Авторы подчёркивают, что сам frontier в эту эпоху почти не ушёл дальше GPT-4, поскольку Turbo и 4o создавались более дешёвыми и быстрыми, а не более умными.
Релиз o1-preview от OpenAI 12 сентября 2024 года обнулил и бенчмарки, и разрыв. Школьная математика уступила место AIME, а тривиа-вопросы - Humanity's Last Exam. На этот раз открытые модели стартовали куда ближе: DeepSeek R1 открыл эпоху с отставанием всего в 12.1 балла. Затем Llama-4 Maverick затормозила набранный R1 темп, Gemini 2.5 Pro и o3 отодвинули frontier дальше, а чекпоинт R1-0528 закрыл исходный разрыв в мае 2025 года с результатом 78 баллов - через 8.5 месяцев после дебюта o1. Anthropic на графиках этой эпохи отсутствует. Авторы объясняют это тем, что компания не боролась за лидерборды по reasoning, а превращала Claude в агента для написания кода по умолчанию - и именно это задало условия третьей эпохи, чьи бенчмарки выполняются в терминале.
Начало агентской эпохи отсчитывают от Opus 4.5: по словам авторов, большинство практиков считают её стартом именно из-за надёжности модели, хотя GPT-5.2 набрала в их наборе тестов больше баллов. Это несоответствие - первый в статье сигнал о том, что главным стал законченный продукт, модель вместе с harness'ом. Релизы флагманов тоже ускорились: в эту эпоху OpenAI и Anthropic выпускали флагманскую модель в среднем каждые 51 день против 213 дней в первой эпохе. Kimi K2.6 обогнал Opus 4.5 в апреле 2026 года с композитным результатом 56.3 через 4.8 месяца после его запуска, а GLM-5.2 превзошёл GPT-5.2 через шесть месяцев после релиза последней, набрав 72.4. На правом краю графика лидирует GPT-5.6 с 99.1 балла, за ней идут Kimi K3 с 93.0 и Fable 5 с 89.5. Две американские открытые модели на графике расположились заметно ниже: Nemotron 3 Ultra набрал 32.7, а Inkling - 51.1.
Трактовка двукратного сокращения
Главный вывод публикации: время, необходимое открытым моделям, чтобы обойти закрытую модель - родоначальницу эпохи, с каждой эпохой сокращается примерно вдвое: 19.7, 8.5, затем 4.8 месяца. Отношения составляют 0.43 и 0.56, так что "вдвое" - вполне честное округление, но три особенности графика ограничивают применимость этого вывода.
Каждая эпоха даёт ровно одно число, так что этот "удивительно стабильный" тренд опирается всего на три точки. Кроме того, отсчёт начинается с публичного дебюта закрытого флагмана, и часть сокращения объясняется тем, что открытые модели выходят в каждой новой эпохе быстрее. В первую эпоху первый серьёзный открытый претендент, Llama-2, появился через восемь месяцев после ChatGPT. В третью эпоху GLM-4.7 вышел уже через месяц после Opus 4.5. Наконец, метрика оценивает лишь момент, когда открытая модель обходит первую закрытую модель эпохи. Она не учитывает, насколько открытый frontier отстаёт от закрытого, который тем временем ушёл вперёд. К августу 2026 года эта остающаяся дистанция между GPT-5.6 и Kimi K3 составляет около шести композитных баллов.
Это различие становится важным при сопоставлении статьи с how-far-behind-are-open-models. Ховард Твейт Иле (Håvard Tveit Ihle), измеряя каждое преодоление порогов на 17 бенчмарках, обнаружил, что разрыв был минимальным во времена R1 в январе 2025 года и с тех пор увеличивался, особенно на приватных бенчмарках. Бенчмарки SemiAnalysis все публичные и подобраны из числа свежих. Их 4.8 месяца укладываются в диапазон 4 - 6 месяцев, полученный Иле для публичных бенчмарков, так что оба исследования сходятся в примерном размере разрыва по публичным тестам, но расходятся в оценке направления его динамики. open-closed-model-gap сопоставляет обе эти оценки.
Оговорки самих авторов
Первая: бенчмарки - это ещё не реальная работа. Kimi K3 опережает Fable 5 по композитному баллу, однако SemiAnalysis в своей ежедневной работе по-прежнему использует Fable. Отчасти дело в готовом продукте: Anthropic поставляет Claude Code и Claude Tag в связке с моделью. Другая причина в том, что публичные бенчмарки легко штурмовать: лаборатория может создать RL-среды, в точности имитирующие задачи бенчмарка. Такое же возражение выдвигается в local-ai-is-not-opus по поводу SWE-Bench, и то же самое отмечает Nathan Lambert касательно индекса Artificial Analysis в open-models-in-perpetual-catch-up.
Вторая: возражение о том, что скорость сокращения разрыва в третьей эпохе выглядит завышенной из-за проверок безопасности (safety testing), поскольку Anthropic и OpenAI задерживают релизы своих моделей ради проверок дольше, чем Moonshot и Zhipu. Авторы отвечают, что в этом нет ничего нового: обучение GPT-4 завершилось за 218 дней до её релиза, и даже если Mythos закончили обучать в середине февраля, до релиза Fable прошло всего 114 дней. По их расчётам, задержка перед релизом сократилась, так что она не может служить объяснением более быстрого сокращения разрыва. Lambert в glm-5-3-how-chinese-labs-keep-stride утверждает противоположное: Z.ai выпускает модели в считанные дни, и месяцы, которые американские лаборатории тратят на тестирование, китайские лаборатории используют для штурма бенчмарков.
В статье также упоминается llm-distillation как одна из причин, почему никакое лидерство не бывает вечным: "Ничто не остаётся секретом навсегда - особенно если учитывать дистилляцию. Вопрос лишь в том, сколько времени это займёт".
Чего нет в сохранённой копии
Во введении авторы обещали продолжить анализ прогнозом на будущее и объяснить, почему этот результат сулит передовым лабораториям меньше пессимизма, чем кажется. Сохранённый текст обрывается сразу после оговорки о проверках безопасности, так и не дойдя ни до одной из этих тем - вероятнее всего, из-за пейвола. На этой странице прогноз привести невозможно, как и итоговые выводы статьи о маржинальности передовых лабораторий.