DeepSeek V4 Flash 0731 набирает 50 баллов в Intelligence Index от Artificial Analysis - на 10 баллов выше прежней DeepSeek V4 Flash
- title
- DeepSeek V4 Flash 0731 набирает 50 баллов в Intelligence Index от Artificial Analysis - на 10 баллов выше прежней DeepSeek V4 Flash
- type
- summary
- summary
- Artificial Analysis оценила DeepSeek V4 Flash 0731 в 50 баллов: на балл ниже GPT-5.6 Luna, на ~60% дешевле за задачу и на Парето-границе стоимости
- tags
- ai, open-weights, benchmarks, llm, china, cost
- created
- 2026-09-14
- updated
- 2026-09-14
- lang
- ru
- translation_of
- deepseek-v4-flash-0731-artificial-analysis
- source_updated
- 2026-09-14
- translated
- 2026-09-14
- translator
- lllm/antigravity/gemini-3.7-flash-medium
Artificial Analysis опубликовала эту короткую заметку с результатами 31 июля 2026 года - в день, когда deepseek выкатила в свой API новый чекпоинт компактной модели V4. DeepSeek V4 Flash 0731 набирает 50 баллов в Artificial Analysis Intelligence Index v4.1, что на десять баллов выше апрельского релиза V4 Flash и на шесть баллов выше заметно более крупной V4 Pro. В open-source-ai-reading-list Нейтана Ламберта эта модель служит примером для одного утверждения: открытые модели находятся на границе Парето по стоимости, даже если не достигают абсолютной границы производительности. В заметке есть цифры, подтверждающие обе стороны этого тезиса.
Где находятся 50 баллов
Индекс представляет собой сводную оценку по девяти бенчмаркам, которые Artificial Analysis запускает самостоятельно: GDPval-AA v2, τ³-Banking, Terminal-Bench v2.1, SciCode, Humanity's Last Exam, GPQA Diamond, CritPt, AA-Omniscience и AA-LCR. С результатом в 50 баллов V4 Flash 0731 делит место с Gemini 3.6 Flash и отстаёт всего на один балл от GPT-5.6 Luna (max), GLM-5.2 (max) и Muse Spark 1.1 (xhigh). Лидером среди открытых моделей остаётся kimi-k3 (max) с 57 баллами. Лидера среди закрытых моделей текст заметки не называет, но он виден на графике: Claude Opus 5 (max) с 61 баллом, Claude Fable 5 с 60 и GPT-5.6 Sol (max) с 59. На конец июля 2026 года в этом индексе лучшая открытая модель отставала от лучшей закрытой на четыре балла, а V4 Flash 0731 - на одиннадцать.
Ценовая сторона
На границу эффективности модель выводит именно цена. Даже после того, как OpenAI в тот же день снизила цену GPT-5.6 Luna на 80%, стоимость одной индексной задачи для V4 Flash 0731 в собственном API DeepSeek оказывается примерно на 60% ниже, чем у Luna (max) - модели, набравшей всего на один балл больше. Artificial Analysis выделяет главный фактор: DeepSeek даёт скидку на попадания в кэш около 98%, тогда как в среднем по индустрии она составляет 90%. Базовые цены - $0.14 за миллион входных токенов и $0.28 за миллион выходных, а попадание в кэш стоит $0.0028; эти тарифы не изменились по сравнению с предыдущей версией V4 Flash. При этом прогон на бенчмарках стал дешевле даже без снижения цен: модель потратила около 206 млн выходных токенов против 234 млн у предшественницы.
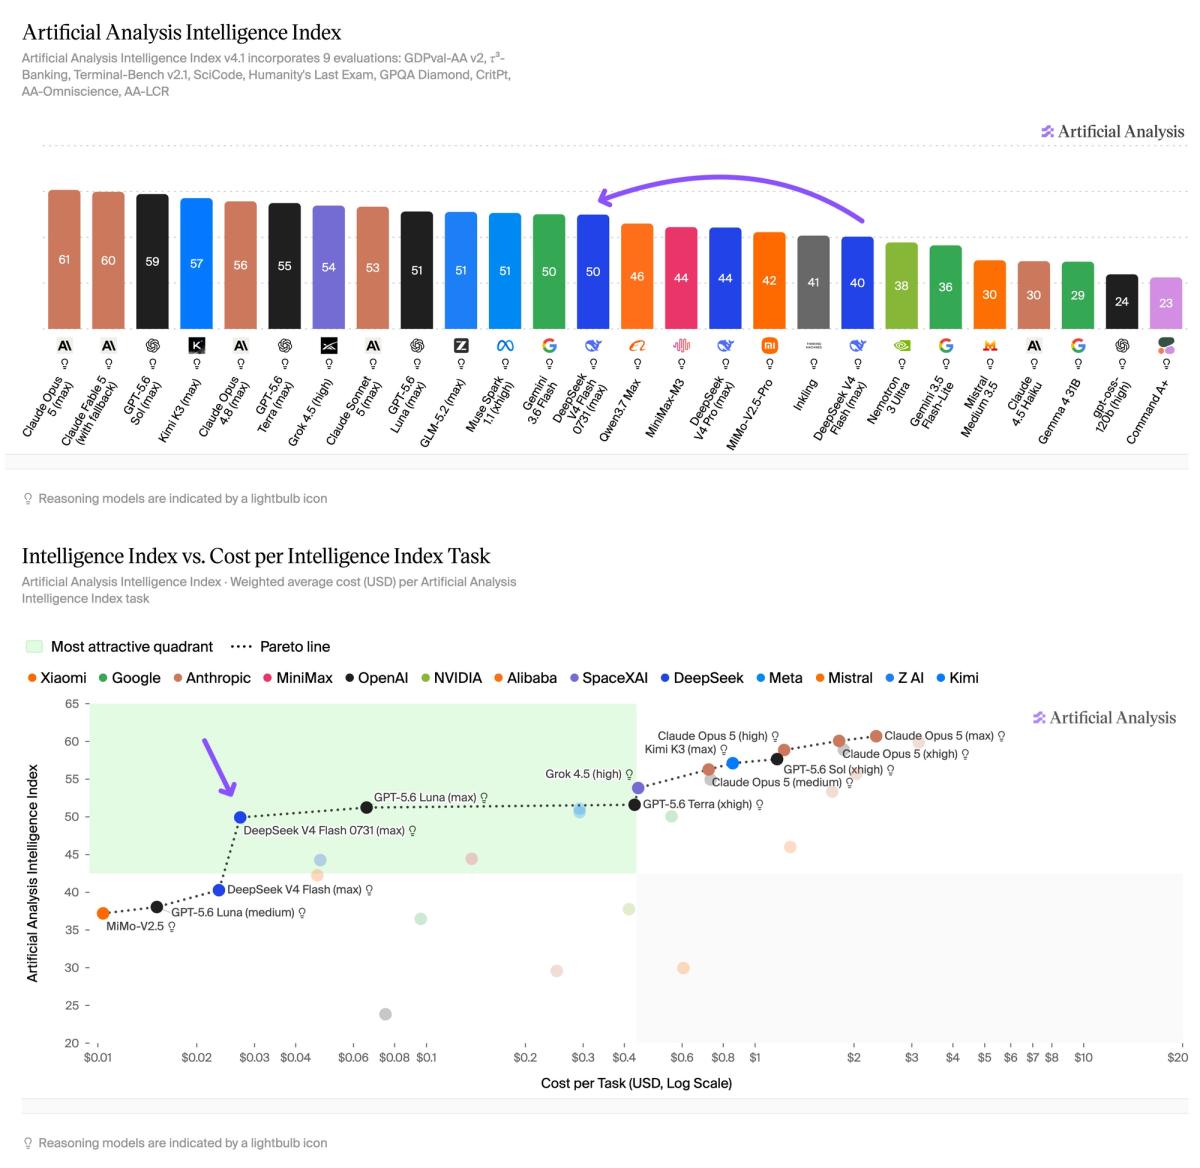
Нижняя панель - это как раз тот график, на который опирается Ламберт. Пунктирная линия Парето идёт от MiMo-V2.5 (около $0.01 за задачу) через V4 Flash 0731 (примерно $0.03) и GPT-5.6 Luna (max) (примерно $0.07) к Kimi K3 (max) (около $0.85) и Claude Opus 5 (max) (около $2.30). На этой линии находятся две открытые модели, и лучшая из них отстаёт от Opus 5 всего на четыре балла. Шкала стоимости логарифмическая - именно против этого в первую очередь возражает intelligence-vs-cost-linear: на линейной шкале долларовый разрыв между дешёвым и дорогим сегментами выглядел бы намного больше.
Форм-фактор модели не изменился. У неё та же архитектура, что и у V4 Flash: 284 млрд параметров всего (из них 13 млрд активных), контекстное окно в 1 млн токенов, а на входе и выходе - только текст.
Что улучшилось
Самый большой прирост - в агентских задачах. В тесте GDPval-AA v2, где Artificial Analysis оценивает выполнение реальных рабочих задач по системе Эло, показатель модели вырос с 1189 до 1559. После публикации весов это будет второй результат среди открытых моделей: позади Kimi K3 (max) с 1687 и впереди GLM-5.2 (max) с 1510. В Terminal-Bench 2.1 результат поднялся на 17 процентных пунктов до 79%, а в τ³-Banking - на 8 пунктов до 31%. Все остальные оценки в индексе тоже выросли: CritPt на 9 пунктов до 17%, SciCode на 5 до 50%, Humanity's Last Exam на 5 до 37%, AA-LCR на 3 до 66% и GPQA Diamond на 1 до 91%.
Результаты по проверке знаний стоит изучить внимательнее: внешняя цифра изменилась, а базовая способность - нет. Индекс AA-Omniscience вырос на 7 пунктов до -16, но точность осталась на уровне 37%. Весь выигрыш был получен за счёт того, что модель стала реже давать неверные ответы: уровень галлюцинаций (доля неверных ответов с уверенным тоном вместо отказа отвечать) снизился до 84%. Artificial Analysis связывает неизменную точность с тем, что число параметров модели не изменилось - это согласуется с идеей о том, что объём фактической памяти ограничен размером модели (factual-capacity-scaling). Уровень галлюцинаций в 84% по-прежнему остаётся близко к нижней части графика, на уровне GPT-5.6 Terra (max) с её 85%.
Оговорки к оценке модели как открытой
На момент публикации V4 Flash 0731 ещё не была моделью с открытыми весами. Доступ к ней был открыт только через API DeepSeek, и Artificial Analysis отмечает, что DeepSeek "планирует выпустить полные веса модели в ближайшие недели". Использование её в качестве примера открытой модели на границе стоимости строится на предположении, что опубликованные веса сохранят то же поведение.
Ценовое преимущество также замерено на собственном API DeepSeek, и заметка объясняет большую часть этой разницы скидкой на кэширование. Возражение Империале в intelligence-vs-cost-linear состоит в том, что Artificial Analysis оценивает открытые модели по ценам API их разработчиков, тогда как сторонние хостинг-провайдеры часто предлагают более низкие тарифы. В данном случае собственный API и так оказывается дешёвым вариантом, а хостинг без сопоставимой скидки на кэш вовсе не обязательно покажет выигрыш в 60%. О более широком вопросе отставания открытых моделей см. open-closed-model-gap.
Неточности в источнике
В тексте заметки падение уровня галлюцинаций указано как 12 пунктов, а в подписи к графику - как 11 пунктов. На самом графике у предшественницы стоит 96%, так что верным является значение 12. Кроме того, подписи к изображениям в веб-клипе смещены на одну позицию: каждая подпись находится над описываемым изображением, а не под ним.