На сколько отстают открытые модели?
- title
- На сколько отстают открытые модели?
- type
- summary
- summary
- Ховард Твейт Иле измерил отставание открытых моделей на 17 бенчмарках: 8-10 месяцев на приватных, 4-6 на публичных и растущий разрыв после R1
- tags
- ai, open-weights, benchmarks, llm, china
- created
- 2026-09-14
- updated
- 2026-09-14
- lang
- ru
- translation_of
- how-far-behind-are-open-models
- source_updated
- 2026-09-14
- translated
- 2026-09-14
- translator
- lllm/antigravity/gemini-3.7-flash-medium
Ховард Твейт Иле (Håvard Tveit Ihle), ведущий закрытый бенчмарк WeirdML, опубликовал этот анализ на LessWrong в мае 2026 года. Материал взят из зеркала greaterwrong и не содержит даты, поэтому месяц взят из open-source-ai-reading-list Нейтана Ламберта. В работе исследуется, на сколько месяцев модели с открытыми весами отстают от лучших закрытых и сокращается ли этот разрыв. В основе анализа - 17 бенчмарков (8 приватных и 9 публичных), дающих около 110 точек данных, в основном взятых из Benchmarking Hub от Epoch AI. Код и данные выложены на GitHub.
Результат
По состоянию на весну 2026 года открытые модели отстают от закрытого фронтира примерно на 8-10 месяцев на приватных бенчмарках (тестовые данные которых закрыты) и примерно на 4-6 месяцев на публичных. Оба тренда достигли минимума в районе выхода DeepSeek R1 в январе 2025 года и с тех пор растут.
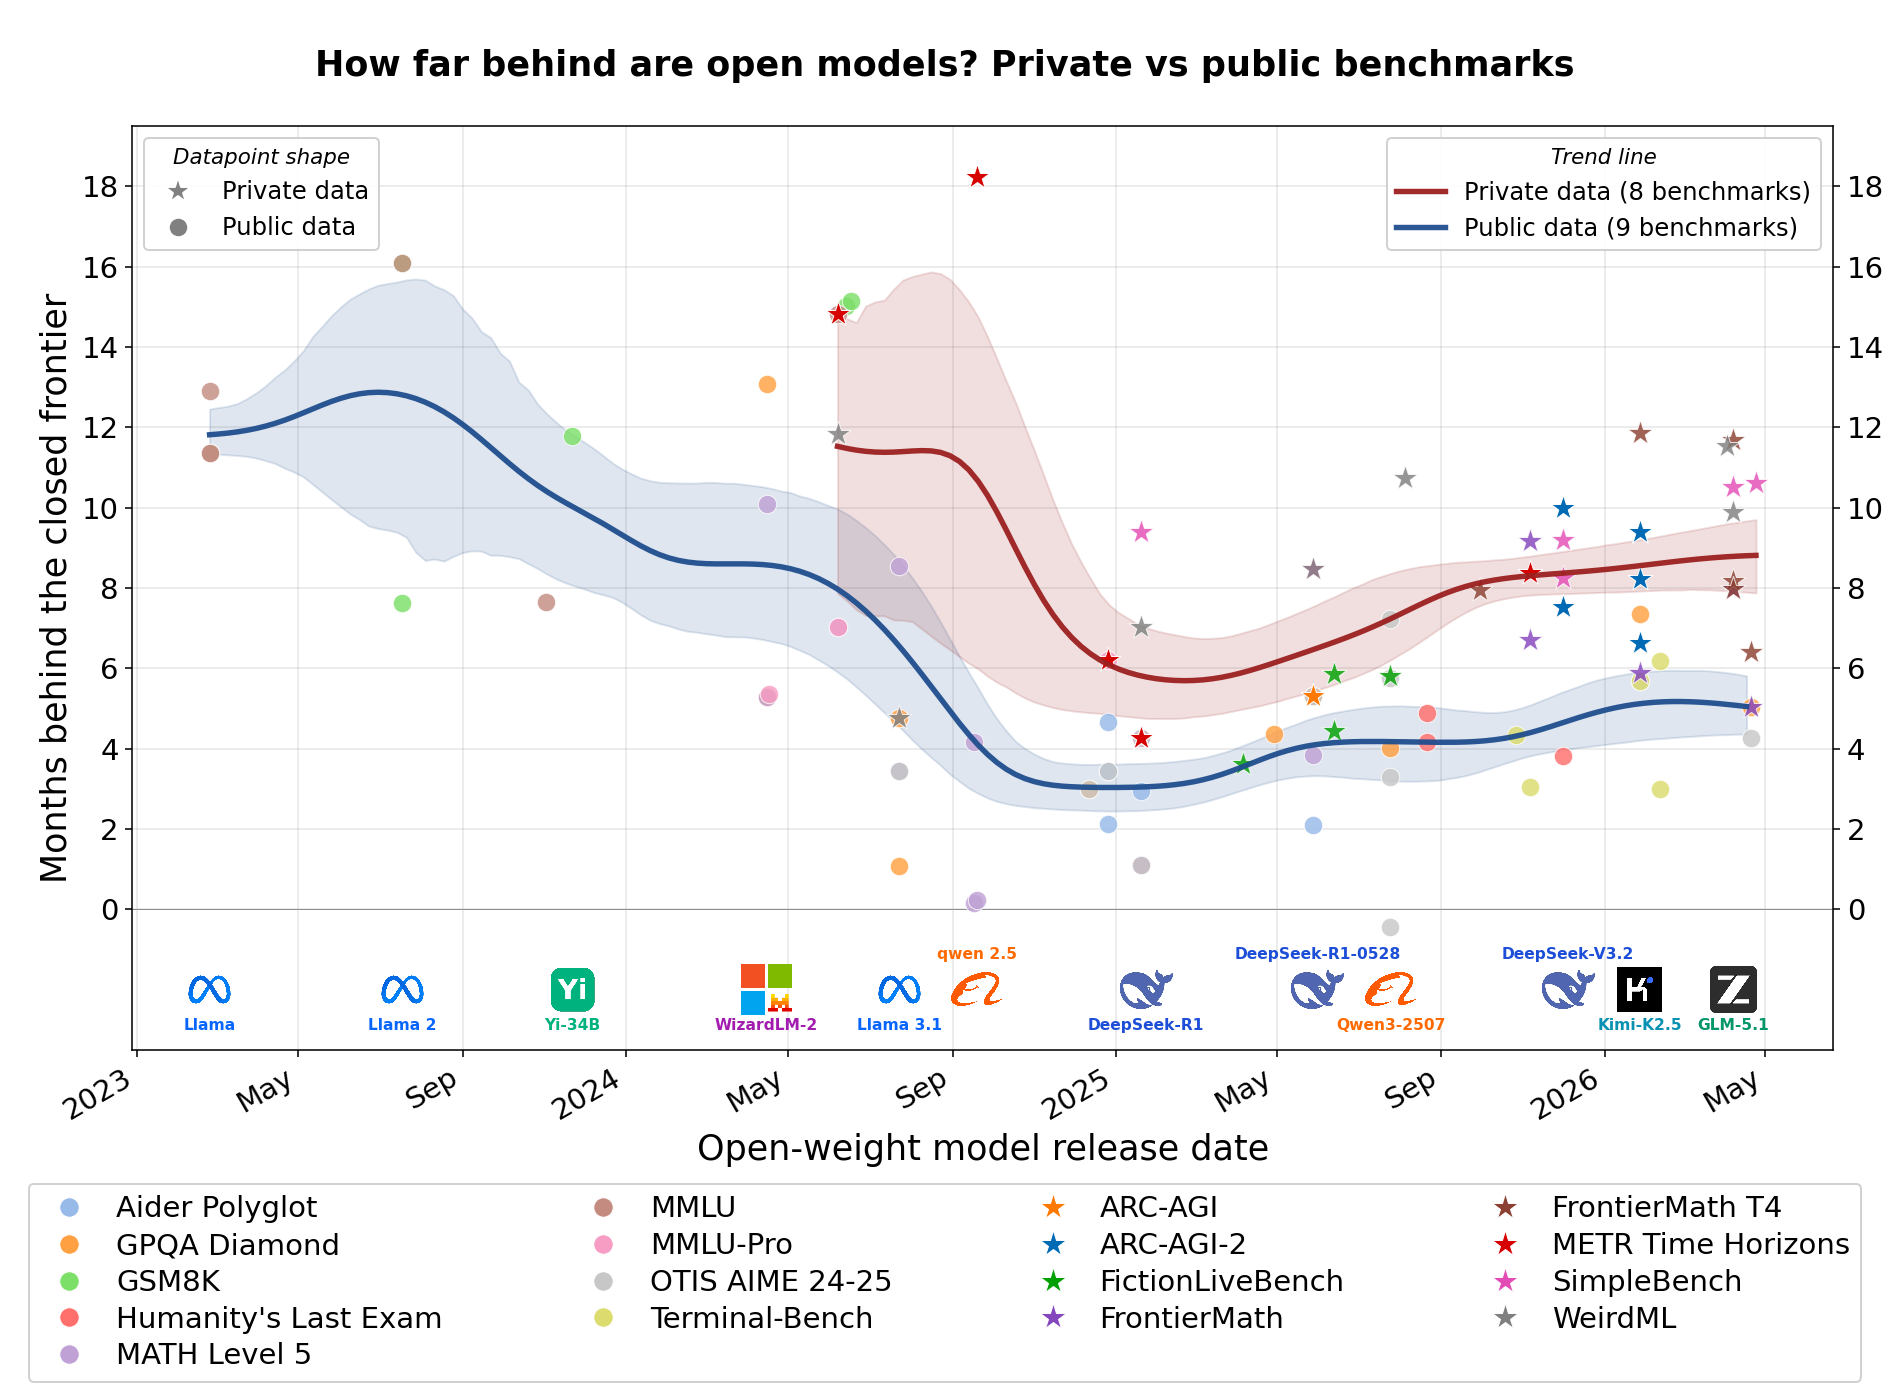
График наглядно передаёт суть аргумента. Публичный тренд (синий) снижается примерно с 12 месяцев в 2023 году до примерно 3 месяцев в начале 2025 года, а затем снова поднимается примерно до 5 к апрелю 2026 года. Приватный тренд (красный) начинается в середине 2024 года, падает примерно до 6 месяцев около релиза R1 и вырастает почти до 9 месяцев к моменту выхода GLM-5.1. Каждая точка - это отдельный порог бенчмарка, привязанный к дате, когда открытая модель впервые его преодолела; высота точки показывает, насколько раньше тот же порог преодолела закрытая модель.
Публичный и приватный наборы не имеют общих бенчмарков, и одинаковое направление их трендов Иле считает признаком того, что тенденция реальна, хотя и оговаривается, что это лишь указание, а не строгое доказательство. Другой вывод касается не тренда, а абсолютных значений: публичные бенчмарки показывают примерно вдвое меньший разрыв, чем приватные. Публичные бенчмарки всё ещё дают представление о возможностях моделей, но занижают отставание почти в два раза.
Как измеряется разрыв
Для каждого бенчмарка строится шкала пороговых значений, обычно с шагом 5%. Для каждого порога разрыв - это время между моментом, когда его преодолела первая закрытая модель, и моментом, когда его достигла первая открытая модель. В качестве примера Иле приводит o1-preview (выпущенную 12 сентября 2024 года), которая преодолела несколько порогов, взятых DeepSeek R1 лишь 20 января 2025 года; это даёт точки данных с разрывом около 4.3 месяца каждая, датированные январём 2025 года.
Метод предполагает, что каждый бенчмарк тестировал все основные модели, чего на практике не было. Поэтому каждый порог проверялся вопросами: правдоподобны ли зафиксированные первые модели и не могла ли отсутствующая модель преодолеть порог раньше, сильно изменив разрыв. Сомнительные точки отбрасывались. Эти оценки и обоснования для них составила Claude Opus 4.7 (они лежат в репозитории). Затем Иле вручную перепроверил их и отменил некоторые решения - во всех случаях ради того, чтобы принять точки, которые Opus отвергла как слишком неоднозначные. Opus также написала практически весь код и одно из приложений.
Привязка каждого разрыва к дате релиза открытой модели делает метрику ретроспективной. Она отвечает на вопрос: "насколько далеко назад нужно вернуться, чтобы найти закрытые модели уровня лучших сегодняшних открытых?" или, по словам Иле, "насколько долго держались разрывы, которые закрывает топовая открытая модель в момент выхода?". Проспективный вопрос - сколько времени пройдёт, пока открытые модели догонят текущий закрытый фронтир, - обычно интереснее, но ответить на него можно только постфактум. Ретроспективный подход также позволяет избежать искажения: пороги, которые закрытые модели уже преодолели, а открытые ещё нет, просто не учитываются, вместо того чтобы ошибочно считаться маленькими разрывами только потому, что они ещё не закрыты.
Искажения в обе стороны
Иле приводит систематические искажения, сдвигающие оценку в обе стороны, что и делает результат практичным.
Метод подвержен "проклятию победителя": модель, первой взявшая порог, часто оказывается той, которой просто повезло с прогоном. А поскольку в бенчмарках обычно тестируется больше закрытых моделей, чем открытых, у закрытых больше "лотерейных билетов". Это завышает разрыв. То же самое делает и способ развёртывания. Чтобы тестовые данные не утекали, приватные бенчмарки часто запускают открытые модели через сторонних провайдеров с нулевым хранением данных (zero data retention) - так делают WeirdML, METR и Epoch AI. Сторонние хостинги порой отдают открытые модели с незаметными багами, что тоже увеличивает разрыв, особенно на приватных бенчмарках.
Утечка данных (contamination) на приватных бенчмарках работает в ту же сторону. FrontierMath проводится компанией Epoch, но финансировался OpenAI: та имеет доступ к большинству задач и сама предоставила результаты для o3. "Полуприватный" набор ARC-AGI при оценке отправляется в коммерческие API: закрытые модели получают его через собственные API разработчиков, а открытые - через сторонние сервисы. Оба фактора завышают результаты закрытых моделей, заставляя закрытый фронтир преодолевать пороги раньше, и тем самым преувеличивают разрыв.
С другой стороны, разница между публичными и приватными результатами указывает на то, что разработчики открытых моделей не до конца очищают обучающие выборки от данных бенчмарков или целенаправленно дообучают модели под тесты. Иле предполагает, что нечто подобное, пусть и в меньшей степени, происходит и с приватными бенчмарками: лаборатории обучают модели на проверяемых задачах, а именно из них и состоят бенчмарки. У создателей закрытых моделей больше разнообразных данных, больше обратной связи от корпоративных клиентов и меньше нужды в красивых баллах на бенчмарках, поэтому он допускает, что разрыв на реальных задачах ещё больше, чем показывают даже приватные тесты. Он подчёркивает, что это предположение, а не вывод из данных. Практический аргумент в пользу этого же тезиса приведён в local-ai-is-not-opus.
Проверка источников данных
В приложении, написанном Opus и слегка отредактированном, проверено, кто именно проводил оценку на каждом бенчмарке. Чистое ядро, где один независимый оценщик тестировал все модели в единой тестовой среде, составляют GPQA Diamond, MATH Level 5 и OTIS Mock AIME (все прогнаны Epoch), а также WeirdML, SimpleBench и METR Time Horizons. GSM8K, MMLU и MMLU-Pro в основном собраны из отчётов вендоров или присланы сообществом, в Aider Polyglot и Terminal-Bench смешаны разные конфигурации, а у Humanity's Last Exam есть отдельная сложность. В данных Epoch почти не было открытых китайских моделей, поэтому пять оценок были вручную добавлены из отчётов самих разработчиков, и каждое первое взятие порога открытыми моделями на HLE в анализе опирается именно на эти строки.
Дополнительные срезы
Группировка бенчмарков по категориям показывает больший разрыв в рассуждениях (reasoning). Однако все три бенчмарка на рассуждения приватные, поэтому Иле списывает разницу на этот фактор и отмечает, что данных слишком мало для более глубоких выводов по категориям.
Ограничение открытой стороны только китайскими моделями даёт практически те же кривые вплоть до Llama 3.1 в июле 2024 года, а до этого момента разрыв был заметно больше. Иными словами, с середины 2024 года открытый фронтир формируют исключительно китайские разработчики. Это согласуется с утверждением из списка литературы о том, что примерно с 2024 года все ведущие открытые модели выпускаются китайскими лабораториями.
В сравнении с другими оценками
Это самая пессимистичная оценка динамики из всего списка литературы. В are-open-models-catching-up утверждается, что время догона сокращается вдвое с каждым поколением, а сам список литературы говорит о сокращении разрыва до 4-6 месяцев. Цифра Иле по публичным бенчмаркам совпадает с этой оценкой. Однако он добавляет показатель приватных бенчмарков - почти вдвое больший - и тренд на увеличение разрыва с января 2025 года. В open-models-in-perpetual-catch-up в феврале 2026 года утверждалось, что разрыв стабильно держится на уровне около шести месяцев, а индекс Artificial Analysis его занижает. Сопоставление всех этих оценок собрано в open-closed-model-gap.